Startseite / Beiträge / Forschung
Was uns 45 Experimente auf IBM Heron tatsächlich gelehrt haben
Die Experimentkampagne hinter der Grundlagenarbeit und die drei Erkenntnisse, die den Entwurf der zweiten Arbeit verändert haben.


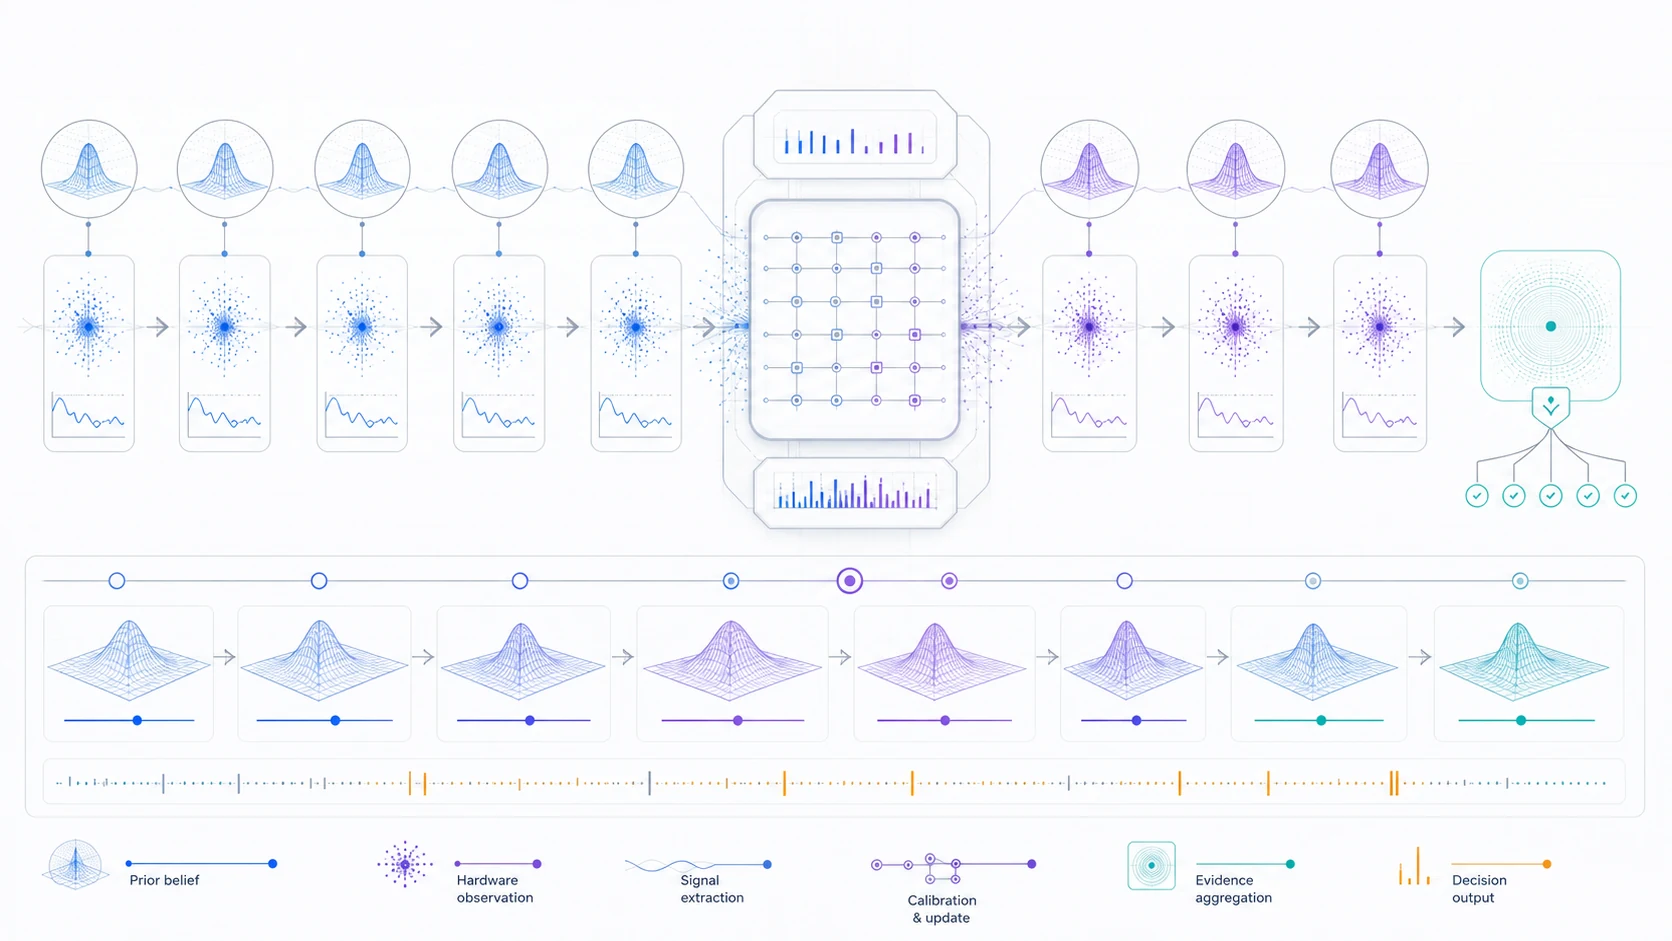
Die QANTIS-Grundlagenarbeit umfasst 31 Seiten mit 4 Abbildungen und 12 Tabellen. Ein großer Teil behandelt 45 Experimente auf drei IBM-Heron-Backends. Warum so viele Durchläufe? Weniger hätten uns womöglich Ergebnisse glauben lassen, die nicht stimmen.
Die drei Komponenten
Die Plattform verbindet drei sonst häufig getrennt untersuchte Komponenten: Quanten-Belief-Updates mittels Grover-Amplitudenverstärkung und BIQAE, Datenassoziation mehrerer Ziele als QUBO mit FPC-QAOA sowie kombinierbare Fehlerminderung über beide Komponenten.
Genau deshalb wurden sie gemeinsam untersucht. Ein isoliertes Belief-Update-Ergebnis sagt wenig darüber aus, was geschieht, wenn dieselbe Hardware im selben Kalibrierzustand auch ein Assoziationsproblem bewältigen muss.
Was die Versuchsreihe verändert hat
Backend-Identität zählt mehr als Backend-Spezifikation. Drei Heron-Prozessoren mit derselben nominellen Spezifikation verhielten sich nicht austauschbar. Effekte, die auf einem Backend wie Methodeneffekte wirkten, erwiesen sich auf einem anderen als Kalibrierungseffekte. Ein Ergebnis ohne Angabe des Backends und des Kalibrierungszeitfensters ist nicht reproduzierbar. Wir behandelten diese Angaben deshalb als verbindliche Anforderung statt als bloße gute Praxis.
Mitigation komponiert schlecht, wenn man es zulässt. Fehlerabschwächungsverfahren, die einzeln ein Ergebnis verbessern, können sich so beeinflussen, dass ihre Kombination schlechter abschneidet als jedes Verfahren allein. Ausgesprochen wirkt das nicht überraschend; bei nur einer untersuchten Konfiguration ist es jedoch leicht zu übersehen.
Die interessanten Zahlen sind an der Grenze. Das klare Ergebnis der Arbeit verstärkt die Wahrscheinlichkeit einer seltenen Beobachtung von 0.179 auf 0.907 bei einer Hellinger-Distanz von 0.0015 zur exakten Bayes-Berechnung. Es liegt im Zentrum des gültigen Betriebsbereichs. Es ist real, aber am meisten lernten wir aus den Durchläufen nahe der Belastungsgrenze der Hardware.
Wie sie die zweite Arbeit geprägt hat
Die sequentielle Studie existiert aufgrund einer Lücke, die die erste Kampagne offensichtlich machte. Jedes dieser 45 Experimente war am Ende eine Einzelbildmessung eines Mechanismus. Keiner von ihnen erzählte uns, was passiert, wenn der Glaube-Update-Dienst wiederholt aufgerufen wird und seine Ausgabe die nächste vorher füttert.
Das Follow-On fragt also genau das, über einen sequentiellen Tiger POMDP Horizont, mit 8- und 12-Schritt-Primärkampagnen und 20-Schritt- und 32-Schritt-Steuerungen. Die Steuerelemente sind speziell da, um den Fehler zu finden, nicht um den Erfolg zu bestätigen.
Die Sache, die ich jemandem sagen würde, beginnt
Entwerfen Sie die Kampagne so, dass ein Nullergebnis publizierbar ist.
Wenn der Experimentplan nur dann eine Arbeit hervorbringt, wenn die Methode funktioniert, schafft er einen Anreiz, an der Versagensgrenze nicht weiterzusuchen. Die Struktur mit 45 Experimenten kostete viel Wartezeit, lieferte aber unabhängig vom Ausgang berichtenswerte Ergebnisse. Das ist den Aufwand wert.
Beide Arbeiten sind öffentliche Preprints auf arXiv. Keine wurde begutachtet; keine beansprucht einen Laufzeitvorteil gegenüber starken klassischen Methoden.